Le 17 novembre 2026, Visions et Prometheus-X ont organisé un webinaire intitulé « Trust, interoperability and collaboration: the next generation of data spaces ». 121 participants y ont pris part : responsables de data spaces, architectes, développeurs et contributeurs open source.
Deux questions ont structuré la session : comment automatiser la confiance, et comment collaborer pour construire cette couche commune ? Voici ce qui a été présenté, ce qui fonctionne déjà et la manière dont vous pouvez rejoindre les travaux.
Le point de départ : la confiance libère les données les plus sensibles
Dans chaque secteur, les acteurs cherchent des réponses précises à partir de données privées détenues par d’autres, souvent par leurs concurrents. Une salle de spectacle veut savoir si son taux de remplissage est normal. Un acteur de l’éducation cherche quels outils pédagogiques fonctionnent sur un territoire, un acteur de la santé quels sont les effets réels d’un médicament sur plusieurs années. Ces questions concernent l’éducation (xapi4research), les compétences (DS4Skills), la culture (Technè), l’énergie et le bâtiment (Location Data Space) et la santé (Health Data Trust).
Une même chaîne dans chaque data space
Partout, la même chaîne se répète. Chez chaque fournisseur, les données brutes ne sortent pas : elles sont traitées localement, anonymisées et alignées sur un modèle commun. Dans le pool commun, seuls des résultats agrégés circulent, sous des seuils de taille et des contrôles de diffusion. Côté usage, on sait qui utilise les données, pour quoi faire, et quelle valeur revient à chaque contributeur. Les briques mobilisées sont toujours les mêmes ; seules les valeurs changent.
La vraie question porte donc sur les règles. Les données sont-elles vraiment anonymisées ? Qu’est-ce qui garantit qu’un concurrent n’accède pas à mes données confidentielles ? Qui vérifie les rôles, et comment ma part de la valeur est-elle calculée ? Ces règles doivent être définies, appliquées et vérifiées, de manière largement automatisée et toujours contrôlable.
Six principes pour une confiance partagée
Six principes encadrent la démarche. Les règles sont définies ensemble, par les data spaces. Elles sont automatisées et vérifiées à chaque échange. Aucune technologie n’est imposée : chaque data space conserve sa propre stack. Seul le minimum est obligatoire, le reste reste local. Et il n’existe pas de solution toute faite : il faut combiner l’existant et se mettre d’accord.
Deux communs pour passer à l’échelle
Pour passer à l’échelle, deux communs sont nécessaires. Le premier est un commun de gouvernance, le Data Space Interoperability Framework (DSIF), où les data spaces fixent les règles minimales pour se fédérer, quelle que soit leur technologie. Le second est un commun logiciel, Prometheus-X, où ceux qui le souhaitent mutualisent en open source les composants qui vérifient et appliquent ces règles. VisionsTrust, comme EDC, FIWARE ou Simpl, n’est qu’une implémentation possible parmi d’autres.
Le fil rouge : xapi4research, une IA de confiance dans l’éducation
Toutes les démonstrations se sont appuyées sur un même cas d’usage. Le ministère de l’Éducation nationale souhaite savoir quels outils numériques, quelles IA et quels profilages d’apprenants fonctionnent réellement, afin de mieux les financer, les acheter et les certifier.
La question posée est concrète : pour chaque profil d’apprenant, quelle personnalisation est efficace ? Les chercheurs ont besoin de traces d’apprentissage au format xAPI : tentatives, indices, temps passé, retours sur une notion. Le premier périmètre porte sur les mathématiques en classe de sixième.
Pourquoi plusieurs EdTech ? Calculé sur un seul outil, un profil décrit les utilisateurs de cet outil. Calculé sur plusieurs, il décrit des élèves, et permet de distinguer l’effet d’une pratique de celui d’un produit. Mais ces données sont doublement sensibles : ce sont des données personnelles d’élèves, soumises au RGPD, et des données concurrentielles entre EdTech. Il faut donc créer la confiance.
Un rulebook commun pour créer la confiance
Olivier Dion (Onecub, Prometheus-X) est parti de la position d’une EdTech à qui l’on demande de partager ses traces avec des concurrents et des chercheurs. Avant de partager, elle se pose cinq questions. Qui accèdera à ses données, et pour quel usage ? Seront-elles vraiment anonymisées ? Un concurrent peut-il isoler ses résultats ? Qui vérifie, et avec quelle preuve ? Peut-elle quitter le dispositif et récupérer ses données ? Un rulebook y répond à l’avance.
Une règle, quatre niveaux
Prenons la crainte d’être identifiée par un concurrent. La réponse devient une règle concrète, inscrite dans le contrat de l’EdTech avec le commun et vérifiée avant chaque diffusion. Aucun agrégat ne porte sur moins de 25 élèves, chaque agrégat réunit au moins 3 EdTech, et aucune ne pèse plus de 50 % du total.
Cette règle n’est pas isolée. Elle repose sur un empilement de quatre niveaux, où chaque niveau peut durcir une valeur mais jamais l’assouplir.
Le niveau L0, commun à tous les data spaces, pose la règle sans en fixer la valeur. Tout échange y est contractualisé, autorisé, tracé et vérifié, et le droit de sortie est garanti. Au niveau L1, DS4Skills fixe un plancher de 10 personnes, déclare les rôles et valide les identités dès l’onboarding. Au niveau L2, le cas d’usage xapi4research relève ce seuil à 20 élèves. Il exige au moins 3 EdTech dont aucune ne dépasse 50 % du total, et réserve les résultats à la recherche publique. Enfin, au niveau L3, le contrat entre l’EdTech et le commun porte la valeur à 25 élèves pour les données de cette EdTech.
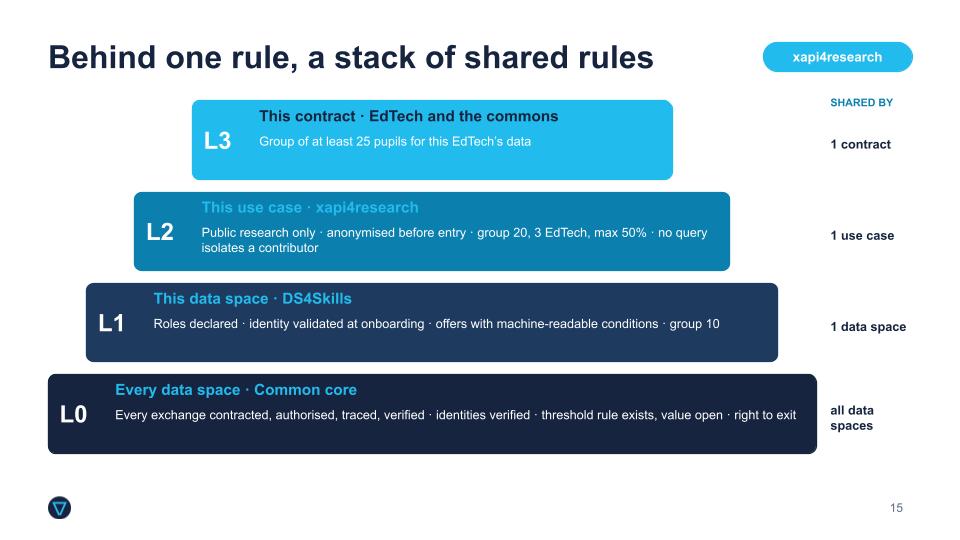
La vérification est assurée par le release gate de l’Edge Node Server, et la preuve est le journal de ce contrôle. Plus une règle est générale, plus il est intéressant de la mutualiser.
Le L0, socle commun à tous les data spaces
C’est l’objet du L0. Pour interopérer et se faire confiance, les data spaces doivent s’accorder sur plusieurs points :
- la manière de vérifier les règles et le niveau de preuve accepté ;
- les critères d’onboarding ;
- les modèles d’offres et de contrats ;
- l’échange de valeur entre data spaces ;
- la gouvernance du L0 lui-même.
Le registre de règles du DSSC (version 0.1 du 23 octobre 2026) compte déjà 36 règles et 4 rôles principaux, dont 9 règles validées. Il s’arrête toutefois là où une fédération commence. Il ne dit pas comment le L0 commun évolue, ni quelles preuves les data spaces acceptent les uns des autres.
Vers la première fédération DSIF
Le DSIF s’appuie sur ce socle avec les data spaces prêts à s’engager. Huit data spaces composent le groupe de départ : DS4Skills, CEADS, DS4SSCC, DEPLOYTOUR, Legal Data Space, Health Data Trust, Technè et Location Data Space. Ils couvrent des secteurs et des stacks différents, centralisés comme décentralisés, et collaborent déjà sur des projets. L’objectif est de voter un L0 V1 contraignant et de lancer la première fédération DSIF le 19 avril 2027. Les membres implémenteront ce L0, et les contrôles réalisés par l’un seront reconnus par les autres.
Des règles lisibles par machine : la rule bank
Félix Bole (Visions, Prometheus-X) a décrit l’écart entre la situation actuelle et ce dont les data spaces ont besoin. Aujourd’hui, un fournisseur doit faire confiance à un PDF, et les contrôles sont manuels quand ils existent. Aucune preuve n’accompagne les échanges, et chaque data space réécrit les mêmes règles. Il faut au contraire des règles qu’une machine sait lire, la bonne brique activée au bon moment, une preuve produite à chaque échange et une traduction unique, partagée par tous.
Chaque règle devient un enregistrement
Dans la rule bank, chaque règle devient un enregistrement structuré qui décrit :
- ce qu’elle dit : énoncé, force, obligation ou interdiction, rôles concernés ;
- où elle se situe : niveau, règle parente, paramètres et qui les fixe ;
- comment elle est appliquée : brique, expression lisible par machine ;
- comment elle est prouvée : contrôle, preuve, qui peut la consulter.
Ce format suit les 15 champs de la fiche de règle du DSSC, enrichis par Prometheus-X de paramètres structurés, d’expressions typées et d’un versionnage.
Chaque niveau ne recopie pas la règle : il y fait référence et en fixe ou durcit les valeurs. Au niveau du contrat, ces valeurs sont associées à leurs règles sources, et l’Edge Node Server les lit directement dans le contrat. Félix a montré en direct, dans VisionsTrust, le contrat signé entre l’EdTech et le commun : la règle en texte, puis sa version technique, lue par le connecteur à chaque échange.
Une architecture compatible avec toutes les stacks
L’architecture repose sur une rule bank partagée par tous les data spaces et un rulebook par data space. Elle s’appuie sur des formats standards : ODRL pour les usages, SHACL pour les métadonnées, Verifiable Credentials pour les participants. Elle fonctionne quelle que soit la stack : Prometheus-X, EDC, FIWARE, Simpl, Solid ou une stack propriétaire. Deux data spaces sur des stacks différentes peuvent ainsi lire et appliquer les mêmes règles dès lors qu’ils partagent un format et des identifiants. 25 règles du L0 sont déjà traduites. Le format est en discussion avec DS4Skills, Health Data Trust, Legal Data Space, Technè et Location Data Space. Le code de la rule bank est disponible sur GitHub.
Le connecteur applique les règles
Nicolas Gretten (Visions) a présenté la cible en cinq étapes. Le connecteur lit le contrat, puis identifie les contrôles et les briques qui s’appliquent. Il déclenche ou vérifie le composant chargé de faire respecter la règle, et récupère une preuve signée et journalisée. Il transfère ensuite les données, ou refuse l’échange. Dans xapi4research, le contrat porte la règle des 25 élèves : sans preuve de l’Edge Node Server, aucun échange n’a lieu.
Ce qui fonctionne déjà
Aujourd’hui, un échange Prometheus-X vérifie déjà le contrat signé et ses politiques ODRL des deux côtés, chez le fournisseur comme chez le consommateur. Nicolas l’a illustré sur une service chain réelle. Les traces de séances de tutorat de Tutorlink passent par l’Edge Node Server de LearnHarbor, puis alimentent le service d’IA d’analyse des apprentissages de xAPI for Research. Chaque participant peut opérer son connecteur en service managé ou en auto-hébergement.
Le connecteur intègre déjà un Policy Enforcement Point (PEP), qui lit et valide les règles d’un contrat pour poursuivre ou bloquer un échange. Il intègre aussi le Data Value Chain Tracker et le Data Veracity Assurance. Depuis la version 1.12, la séparation entre plan de contrôle et plan de données permet de brancher n’importe quel service d’application des règles. Ce qui manque encore, c’est le lien vers les preuves externes : vérifier les règles issues d’un rulebook et s’appuyer sur n’importe quel composant d’application. Le code du connecteur est disponible sur GitHub.
Edge Node Server : la démonstration de bout en bout
László Gönczy (BME, Prometheus-X) a rappelé que, dans les cas sensibles, une partie du traitement doit s’exécuter là où se trouvent les données. Trois types de règles du L0 s’appliquent alors à tous les data spaces : le traitement local, l’anonymisation avant diffusion et le seuil de diffusion. Ce seuil n’autorise que des agrégats au-delà d’une taille de groupe minimale.
Dans xapi4research, cela signifie convertir les traces au format xAPI et les aligner sur le référentiel commun. Il faut ensuite supprimer les identifiants, arrondir les horodatages et exclure le texte libre, puis contrôler la taille du groupe avant toute sortie.
Ce que contient l’Edge Node Server
L’Edge Node Server réunit ces fonctions autour du connecteur, qui sert de point d’entrée et propage les règles jusqu’au nœud. Les données brutes n’y sont jamais stockées, et seuls les résultats validés quittent le nœud. D’autres briques s’y ajoutent : Edge Translator, Data Value Chain Tracker, IA décentralisée par apprentissage fédéré et Learning Record Converter. Ce travail est porté par Prometheus-X, Visions, BME, Inokufu, Headai, IMC, Loria, AffectLog et Rejustify, avec Outscale et Orange Business côté cloud.
Au-dessus et en dessous du seuil
La démonstration a suivi toute la chaîne, des traces de Tutorlink jusqu’au commun de données. Au-dessus du seuil, les données sont préparées sur l’Edge Node Server et le contrôle passe. L’agrégat anonymisé est alors transmis avec sa preuve à xAPI for Research. Sous le seuil, le contrôle échoue : rien ne quitte le nœud, et le refus est journalisé.
La chaîne xapi4research fonctionne aujourd’hui de bout en bout. Le release gate est piloté par les valeurs du contrat, et les refus comme les diffusions sont journalisés comme preuves. Il s’agit encore d’une première preuve de concept à logique figée. Les prochaines extensions portent sur de nouvelles étapes de transformation, un workflow de configuration des nœuds et un usage plus avancé de l’edge computing pour passer à l’échelle.
L’interopérabilité entre data spaces et entre stacks
Félix Bole, Benoit Alessandroni (StartinBlox) et Juanjo Hierro (Seamware) ont présenté l’approche du DSIF. Chaque écosystème fait tourner sa propre stack. Une offre publiée dans un data space reste invisible depuis un autre, les contrats ne traversent pas les stacks, et le consentement et l’identité ne suivent pas les données. Chaque nouvelle paire d’écosystèmes impose une intégration sur mesure.
Le DSIF ne remplace aucune implémentation (Prometheus-X, EDC, FIWARE, Simpl, Solid). Il définit les passerelles minimales entre elles pour découvrir, contractualiser, porter le consentement et reconnaître les identités. Ces passerelles s’appuient sur DCAT, ISO/IEC 27560 et OID4VC.
Un cas d’usage illustre cette prochaine frontière. xapi4research veut croiser les traces d’apprentissage de DS4Skills (stack Prometheus-X) avec la consommation de médias éducatifs et d’information du data space média TEMS (stack EDC). La question posée : l’usage des médias aide-t-il à apprendre ?
Découvrir les offres d’un autre data space
Pour la découverte, les offres restent là où elles sont, mais elles deviennent visibles depuis n’importe quel catalogue fédéré. Cela passe par des autorités d’enregistrement et de recherche sectorielles. La démonstration de StartinBlox l’a montré en quatre temps. L’AFP publie une offre dans TEMS, sur EDC, et sa description est enregistrée dans l’annuaire sectoriel. Tralalère retrouve ensuite cette offre depuis son catalogue DS4Skills, avec ses conditions. Elle contractualise enfin via sa propre stack. TEMS, DS4Skills et FIWARE sont connectés aujourd’hui, et Simpl est la prochaine étape.
Contractualiser d’une stack à l’autre
Pour les contrats, chaque stack contractualise à sa manière, et un acheteur sur une stack ne peut pas signer sur une autre. Le DSIF propose donc un modèle d’intégration neutre et un modèle d’actions commun : consulter une offre, demander une acquisition, enregistrer, suivre, consulter et résilier un accord. Ce modèle est aligné sur les standards existants et compatible avec les projets multi-fournisseurs.
Faire suivre le consentement
Pour le consentement, une interface commune doit permettre au récepteur de vérifier la finalité, le périmètre et le retrait avant chaque échange. Le consentement peut avoir été donné dans le consent manager de Prometheus-X, dans un pod Solid d’Athumi ou ailleurs. Une analyse d’écart et des itérations de spécification sont en cours.
Une reprise dans les standards
Ces travaux sont repris dans les standards :
- par le DSSC : couches de gouvernance des rulebooks, champs contractuels, auto-description pour la fédération ;
- par le CEN-CENELEC JTC 25 : services de découverte, consentement ;
- par Gaia-X : clauses contractuelles, contrats multipartites.
Prochaine étape : un assistant ouvert pour les data spaces
Matthias De Bièvre (Visions, Prometheus-X) a pointé un nouveau point de friction. Avec de nombreux data spaces, cas d’usage, offres et règles connectés, la difficulté ne vient plus de la technologie. Elle vient de la capacité à trouver, comprendre et appliquer les bonnes règles. Quelles offres répondent à mon besoin ? Quelles règles s’appliquent à mon projet ? Que dois-je vérifier et prouver ? Comment contractualiser rapidement ?
Du besoin au projet gouverné
L’assistant présenté permet à une organisation de décrire son besoin en langage courant. Il recherche dans les catalogues fédérés, propose des offres, préremplit le projet et suggère les règles à appliquer à partir des rulebooks et de la rule bank.
La démonstration, réalisée sur VisionsTrust, est partie d’un besoin saisi en quelques mots pour aboutir à un projet gouverné. L’assistant a sélectionné des offres et un Edge Node Server, puis constitué un panier avec prix et conditions. Il a ensuite créé le projet et recommandé des règles par rôle, issues du rulebook xapi4research. La demande de contrat a enfin été envoyée.
Mutualiser pour mieux recommander
Aujourd’hui, l’assistant s’appuie sur des données publiques : environ 15 000 offres issues de catalogues publics et une cinquantaine de cas d’usage couvrant 8 secteurs. Ses suggestions restent donc limitées aux data spaces opérés par Visions et à des cas d’usage génériques. L’ajout des contrats, des règles et de leurs modes d’application le rendra plus précis. Mutualiser ces connaissances entre data spaces le rendrait pertinent pour tous. Le périmètre, la gouvernance et le modèle économique de cette mutualisation restent à décider ensemble.
L’atelier et les prochaines étapes
La session s’est conclue par un atelier sur le Mural, où chaque intervenant animait les échanges sur son sujet. Les échanges ont été nombreux : les participants ont indiqué les sujets sur lesquels ils souhaitent contribuer, et plusieurs ont précisé leur proposition en direct. Ils confirment une réelle volonté de collaborer pour construire ensemble cette couche commune.
Chaque post-it recevra une réponse, qu’il ait été discuté en séance ou non. L’équipe reviendra vers chaque contributeur pour définir concrètement sa participation, et le Mural reste ouvert. Pour rejoindre les travaux sur le rulebook, contactez Olivier Dion à olivier@onecub.fr. Pour l’interopérabilité technique et la rule bank, contactez Félix Bole à felix@visionspol.eu.
À retenir
La confiance entre data spaces ne se décrète pas dans un document. Elle se construit avec des règles communes, lisibles par machine, appliquées et prouvées à chaque échange. Le webinaire a montré que cette chaîne fonctionne déjà de bout en bout sur un cas réel, du rulebook jusqu’au release gate de l’Edge Node Server.
Il a aussi montré ce qui reste à faire ensemble : s’accorder sur un L0 contraignant et traduire les règles restantes. Il faudra aussi généraliser la vérification des preuves dans le connecteur et étendre les passerelles entre stacks. Le prochain jalon est fixé : le vote du L0 V1 et le lancement de la première fédération DSIF le 19 avril 2027. Si votre data space souhaite en faire partie, c’est le moment de s’engager.
Nous remercions les 121 participants ainsi que nos intervenants :
- Olivier Dion (Onecub, Prometheus-X) ;
- Félix Bole (Visions, Prometheus-X) ;
- Nicolas Gretten (Visions) ;
- László Gönczy (BME, Prometheus-X) ;
- Benoit Alessandroni (StartinBlox) ;
- Juanjo Hierro (Seamware) ;
- Matthias De Bièvre (Visions, Prometheus-X).
Si vous n’avez pas pu assister au webinaire en direct, le replay est disponible ci-dessous. Vous pouvez également consulter la présentation utilisée lors du webinaire.
Vous souhaitez rejoindre la fédération DSIF ou contribuer aux briques open source de Prometheus-X ? Contactez-nous à matthias@visionspol.eu.